
「啊鸡学习 Node FFI」系列(一):从符号地址出发,追踪一次 JavaScript 到 C 的机器 ABI 调用。下一篇是啊鸡学习 Node FFI 之《线程与回调篇》。
先写一个只有一行逻辑的 C 函数:
// mathlib.c
double divide(double a, double b) {
  return a / b;
}
编译成动态库:
# macOS
cc -dynamiclib mathlib.c -o libmath.dylib

# Linux
cc -shared -fPIC mathlib.c -o libmath.so
用 Koffi 调它:
// call.cjs
const path = require("node:path");
const koffi = require("koffi");

const libraryName = {
  darwin: "libmath.dylib",
  linux: "libmath.so",
}[process.platform];

if (libraryName === undefined) {
  throw new Error("This example only covers macOS and Linux");
}

const libraryPath = path.join(__dirname, libraryName);
const library = koffi.load(libraryPath);
const divide = library.func("double divide(double, double)");

console.log(divide(6.0, 2.0));
3
输出 3。这篇文章只追这一次 divide(6.0, 2.0):6.0 和 2.0 是怎样从 JavaScript number 变成 C 真正收到的参数的。path.join(__dirname, ...) 让动态库路径跟着脚本走,不随启动目录漂移。
1. 编译时和运行时各做了一半工作
构建 mathlib.c 时,编译器已经知道 divide 的 prototype:
double divide(double a, double b);
它据此生成 divide 的机器码,链接阶段形成动态库和导出 symbol。这些都是 build-time 工作,不会在每次 JavaScript 调用时重做。
运行 call.cjs 时的另一半分成“准备一次”和“调用一次”:
require("koffi")加载连接 Node 与 native code 的 Koffi Addon;koffi.load(libraryPath)让动态 loader 打开库文件;library.func(...)取得divide的机器码入口,并保存double divide(double, double)这份调用声明。
执行 divide(6.0, 2.0) 时:wrapper 把两个 JavaScript number 写进两个 double native storage,ABI backend 按声明把值送进平台规定的寄存器,CPU 跳到目标地址执行,返回后 wrapper 再把 double 结果转回 JavaScript number。
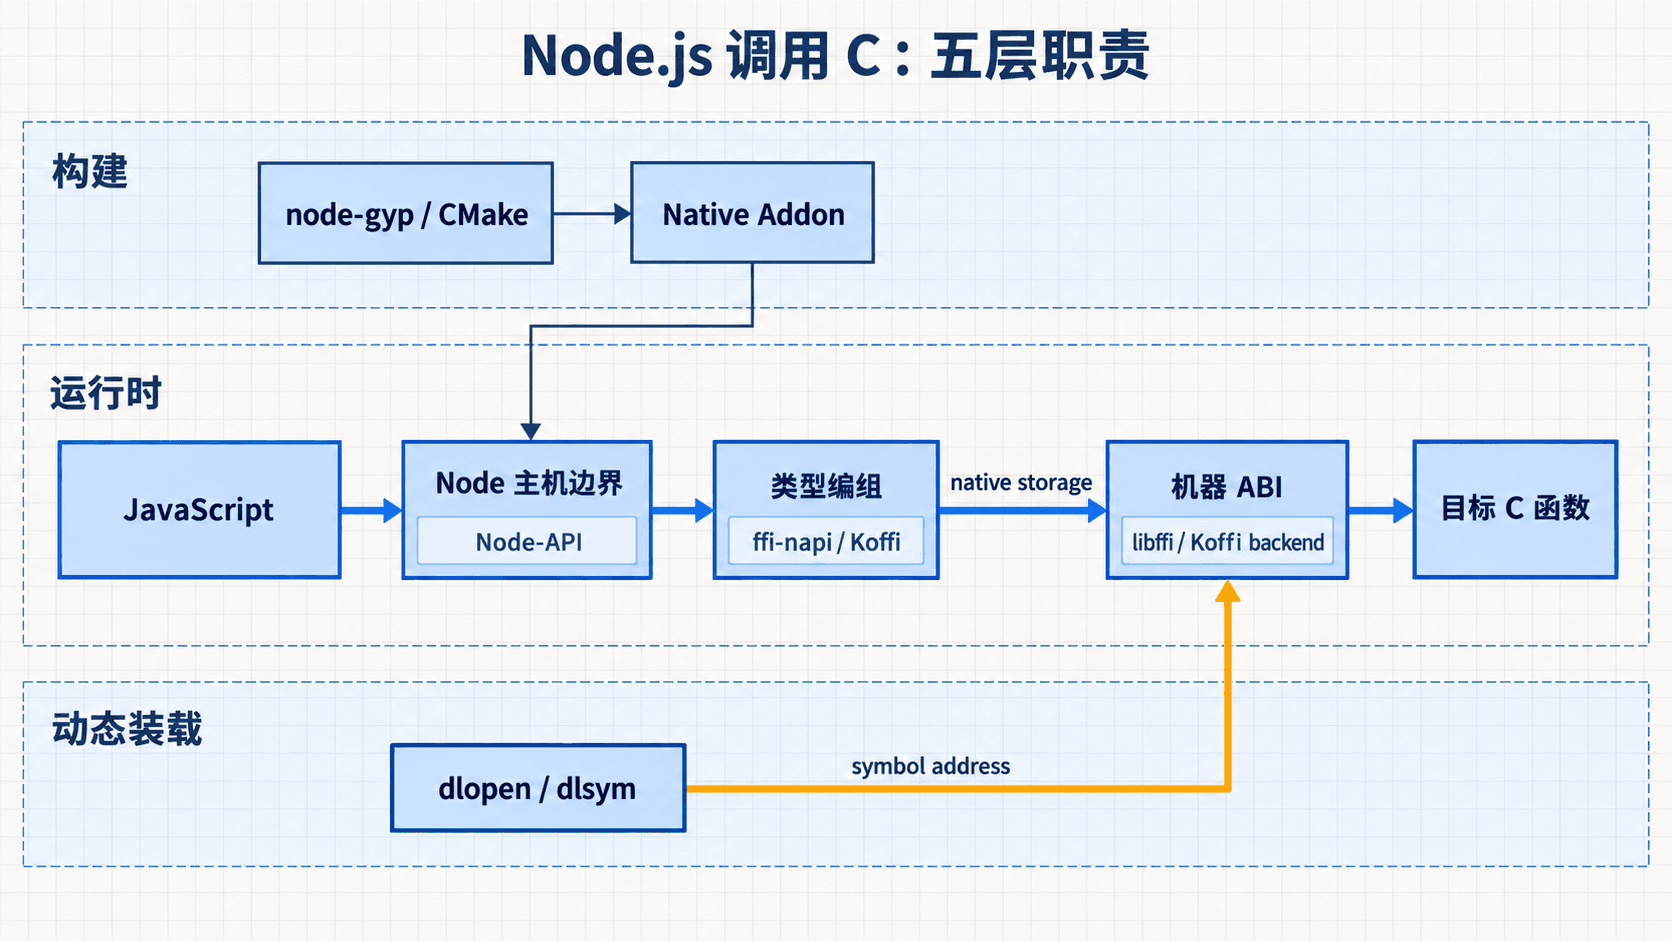
图中五层分别覆盖构建、Node 主机边界、动态装载、类型编组和机器 ABI。后文沿同一个 divide 调用拆开后三层。
这一切发生在同一个 Node 进程、同一个地址空间里,不是把 JSON 消息发给另一个服务。代价是错误也没有进程边界兜底:错误的 prototype、越界写或悬空 pointer 都可能带崩整个 Node 进程。Worker Thread 也救不了——它仍在同一进程里;需要隔离 native crash 时,要把调用放进独立进程。
2. Symbol address 里没有 prototype
动态 loader 能回答的只是:
"divide" → 0x7ff8...
这个地址告诉 CPU 从哪里开始执行,却没有说参数有几个、是 int 还是 double、struct 按值传还是传地址、返回值走寄存器还是内存、用哪种 calling convention。在 Unix-like 系统上,取得地址的代码大致是:
void* handle = dlopen(library_path, RTLD_NOW | RTLD_LOCAL);
void* symbol = dlsym(handle, "divide");
dlsym() 不会从地址里反推出 double divide(double, double);prototype 必须来自真实 header、厂商文档或生成的 binding。库能打开、symbol 能找到,只证明“有这个入口”,不证明“调用帧准备正确”。
所以这行字符串不是给编辑器看的类型提示:
const divide = library.func("double divide(double, double)");
Koffi 靠它决定 6.0、2.0 和返回值各用什么 native 表示,并据此生成机器调用。
3. 同一个地址,prototype 不同,寄存器就不同
先只看 x86-64 System V ABI,即常见的 x86-64 Linux / macOS 规则。正确声明下,divide(6.0, 2.0) 可以先用这个简化模型理解:
6.0    → XMM0
2.0    → XMM1
3.0    ← XMM0
如果 JavaScript 侧误写成:
// 错误示意:不要执行
const divide = library.func("int divide(int, int)");
caller 会按整数调用帧准备同一组表面值:
6      → EDI(RDI 寄存器族的低 32 位)
2      → ESI(RSI 寄存器族的低 32 位)
result ← EAX
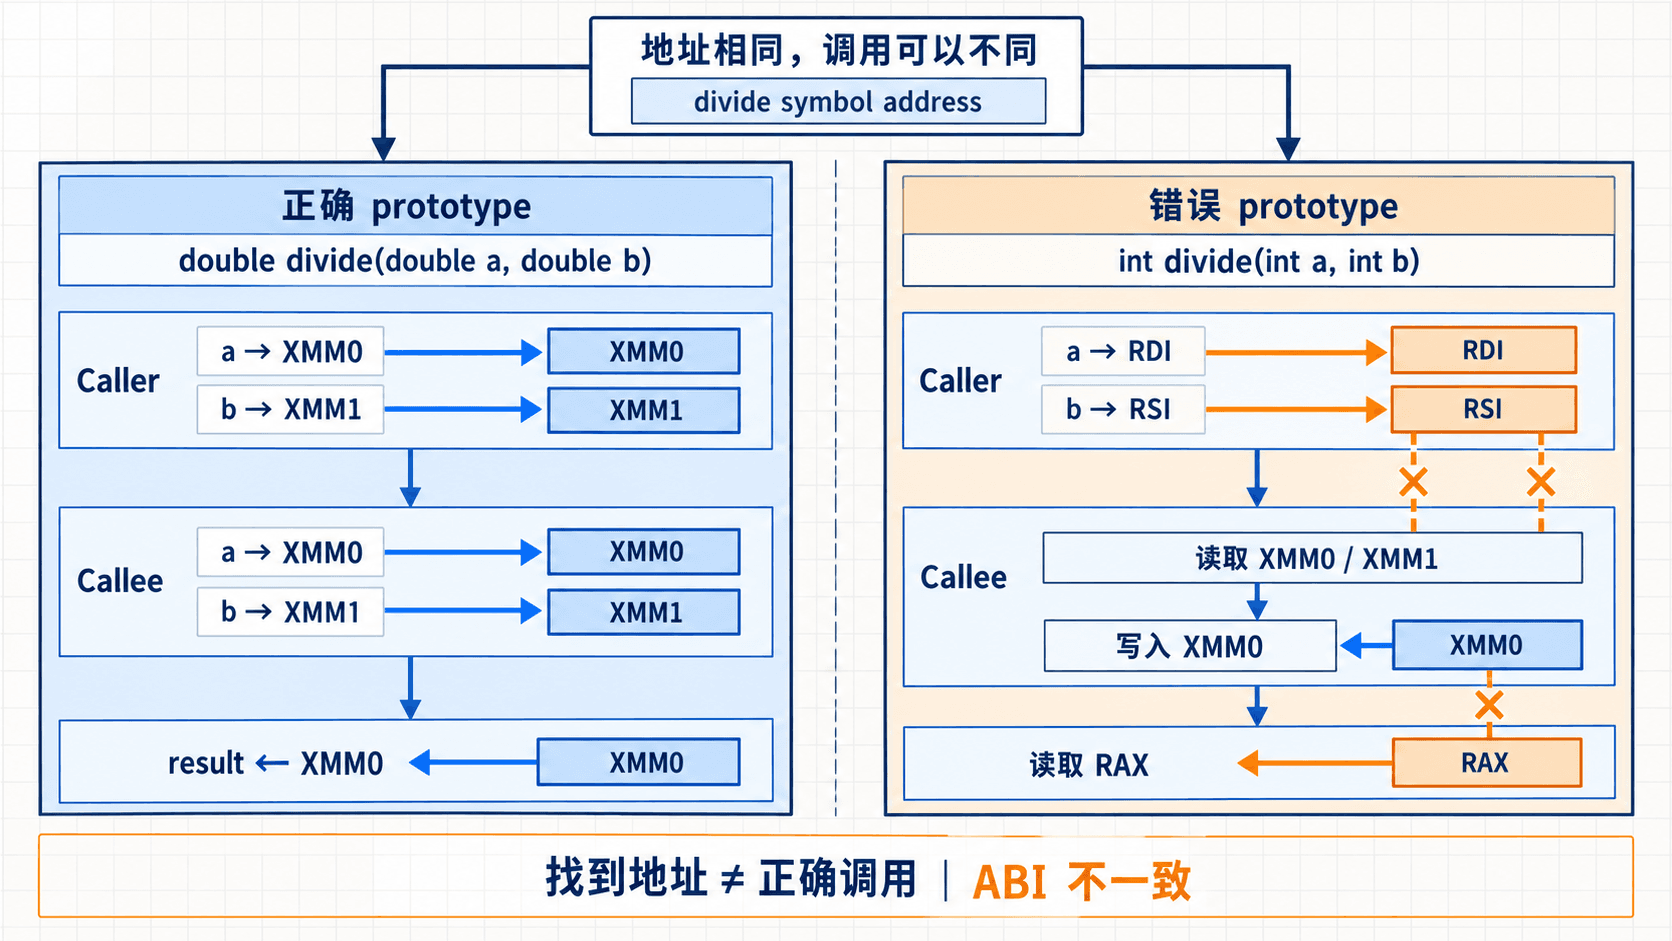
图中用 RDI、RSI、RAX 标的是 System V ABI 的整数寄存器族;对 32-bit C int,有效位置具体落在 EDI、ESI、EAX。目标地址没有变化,但 caller 与 callee 已经在说两套二进制协议:callee 从 XMM0 / XMM1 读 double,错误 caller 却把整数写进整数通道;callee 把结果写到 XMM0,错误 caller 又从 EAX 读。这是 undefined behavior——不要把它当实验跑,它可能崩溃,也可能先破坏内存、稍后才在无关位置出错。
这些寄存器名称只适用于 x86-64 System V;Windows x64、ARM64、struct 按值传等各有规则,但分析方法相同:**prototype 决定值的表示,ABI 决定这些值落在哪里。**对当前 divide,要逐项对上的是参数个数、两个 double 参数、double 返回值和 calling convention。
4. libffi 怎样调用运行时才知道的函数
Koffi 不调用 libffi,它有自己的 ABI backend。要看清“运行时 ABI backend”需要哪些输入,这里切到 ffi-napi 采用的 libffi 路线;两者承担同一层职责,是替代实现,不是前后串联。
libffi 面对的问题是:函数地址和类型描述到运行时才出现,C 编译器无法预先为每种组合生成固定调用指令。核心只有这几步(省略错误处理):
// call-divide.c
void* handle = dlopen(library_path, RTLD_NOW | RTLD_LOCAL);
void* symbol = dlsym(handle, "divide");        // 目标函数入口

ffi_cif cif;
ffi_type* argument_types[] = {
  &ffi_type_double,
  &ffi_type_double,
};
ffi_prep_cif(&cif, FFI_DEFAULT_ABI, 2, &ffi_type_double, argument_types);

double a = 6.0;
double b = 2.0;
double result = 0.0;
void* argument_values[] = { &a, &b };           // 实参 storage 的地址

ffi_call(&cif, FFI_FN(symbol), &result, argument_values);
printf("%.1f\n", result);                       // 3.0
上面只是核心片段,不能独立编译;还需补上 headers、main()、library_path 初始化和错误处理。调用成功时结果为 3.0。两个阶段:ffi_prep_cif() 按 ABI、参数类型和返回类型准备可复用的调用描述;ffi_call() 接收 CIF、symbol 地址、result storage 和实参 storage 地址数组,完成一次调用。
尤其要看这一行:
void* argument_values[] = { &a, &b };
argument_values[0] 指向保存 double a 的 storage,[1] 指向 b 的 storage。这个 void ** 形状属于 libffi 自己的调用 API,并不表示目标函数变成了 double divide(double**, double**)。libffi 先从这些地址读出两个 double,再按 CIF 和目标 ABI 把值送进 XMM0、XMM1 或其他平台规定的位置。
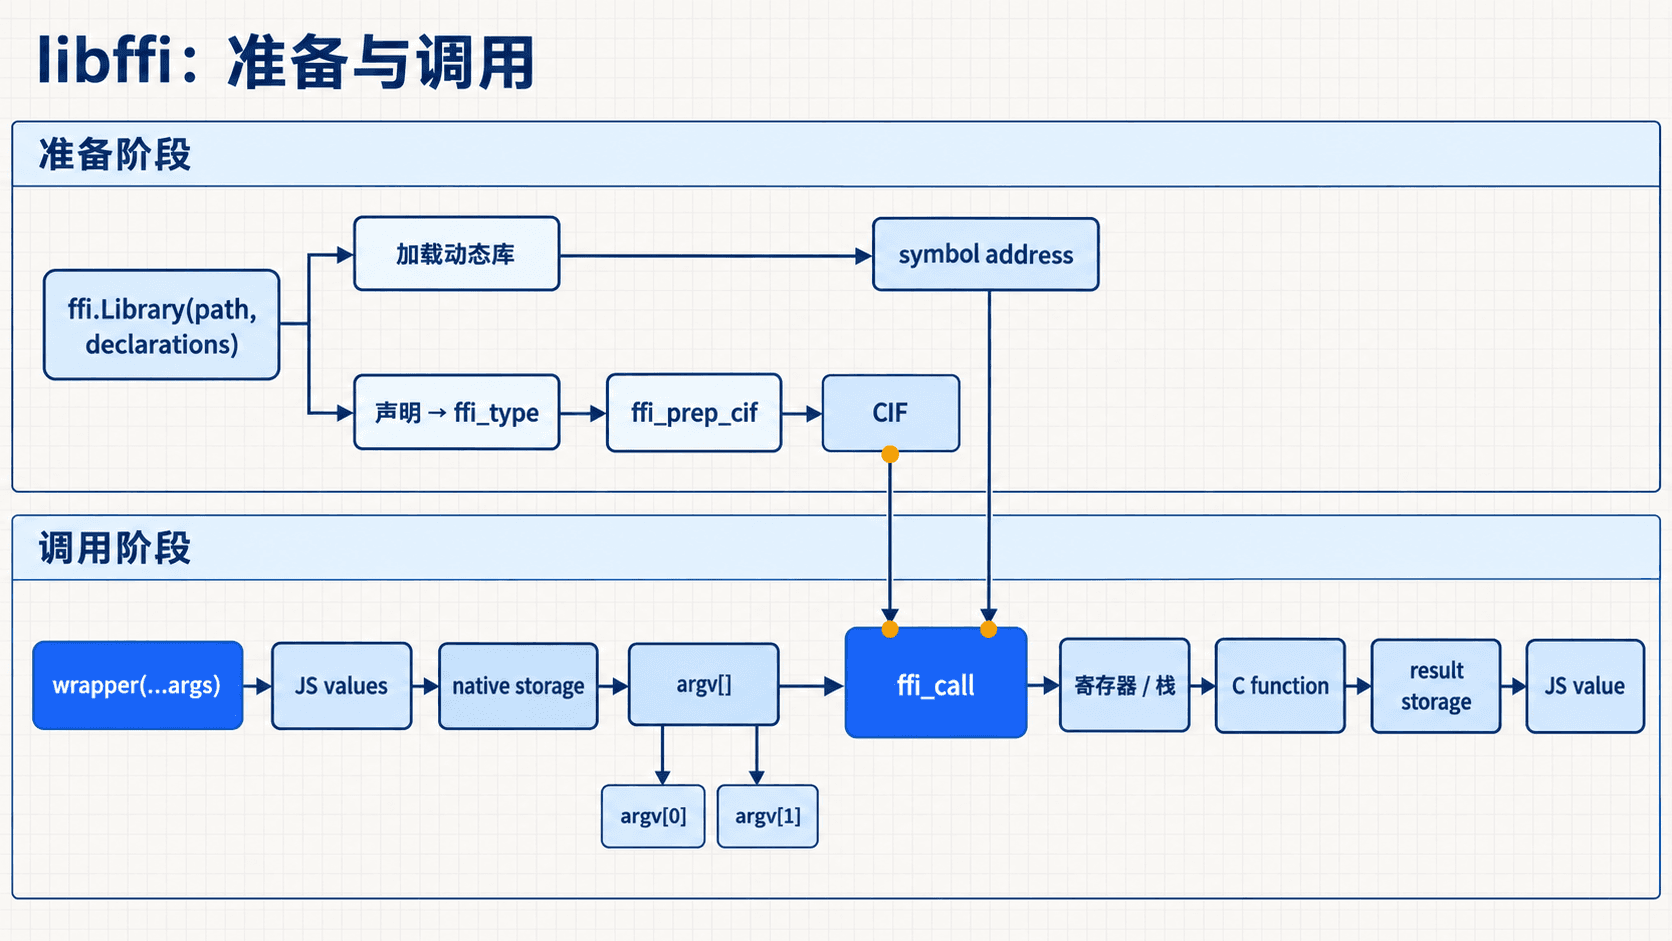
把这套机制放回 ffi-napi 的 Node wrapper,前后只多出 JavaScript 值转换:声明先变成 ffi_type 和 CIF;每次调用把 JavaScript 参数写进 native storage,执行 ffi_call(),再从 result storage 创建 JavaScript 返回值。
5. Node-API 与 libffi 跨的是两条边界
ffi-napi 已经使用 Node-API,为什么还需要 libffi?因为两者面对的调用双方不同:
Node-API:Native Addon ↔ Node runtime
libffi:  Native Addon ↔ divide 等目标 C 函数
Node-API 通过 napi_env、napi_value 等 opaque handle,让 Addon 不必依赖 V8 对象的内部布局;node-addon-api 只是这套 C API 的 header-only C++ wrapper,不是另一种 FFI 引擎。libffi 不认识 JavaScript 对象,却能根据运行时类型描述准备机器调用。Koffi 没有用 libffi,而是自己实现类型系统、ABI analyzer 和 architecture-specific call gate;它绕开的是 libffi 这项实现依赖,不是 ABI 约束本身。
Node-API 的稳定保证也只覆盖 Node-facing 这条边。以本文核对的 ffi-napi@4.0.3 为例:它虽使用 Node-API,却仍直接调用 libuv work queue、async handle、mutex 和 thread API,预构建配置也带 UV ABI 标签。包名里的 napi 不能把 Node-API 的跨 Node major 保证外推到整个 package。
6. 四种方案怎样完成同一次 divide
把需求固定为“加载动态库并调用 divide(6.0, 2.0)”,四种路线的调用表面可以压缩成:
// 以下是四种独立路线的表面调用;libraryPath 沿用开篇的平台选择。

// node-ffi:历史路线
const ffi = require("ffi");
const legacy = ffi.Library(libraryPath, {
  divide: ["double", ["double", "double"]],
});
legacy.divide(6.0, 2.0);

// ffi-napi
const ffiNapi = require("ffi-napi");
const napiFfi = ffiNapi.Library(libraryPath, {
  divide: ["double", ["double", "double"]],
});
napiFfi.divide(6.0, 2.0);

// Koffi
const koffi = require("koffi");
const dynamic = koffi.load(libraryPath);
const koffiDivide = dynamic.func("double divide(double, double)");
koffiDivide(6.0, 2.0);

// 专用 Addon:JavaScript 只看见项目自己封装的接口
const addon = require("./build/Release/math-addon.node");
addon.divide(6.0, 2.0);
这四种方案不是升级链。前三种让通用 binding 在运行时解释声明;专用 Addon 在构建时让编译器读真实 header:
#include <mathlib.h>

double result = divide(a, b);
编译器因此能直接检查声明并生成调用指令,也更适合把 handle、线程和释放协议封进一个窄的 JavaScript API,代价是维护 native source、编译工具链和多平台二进制。
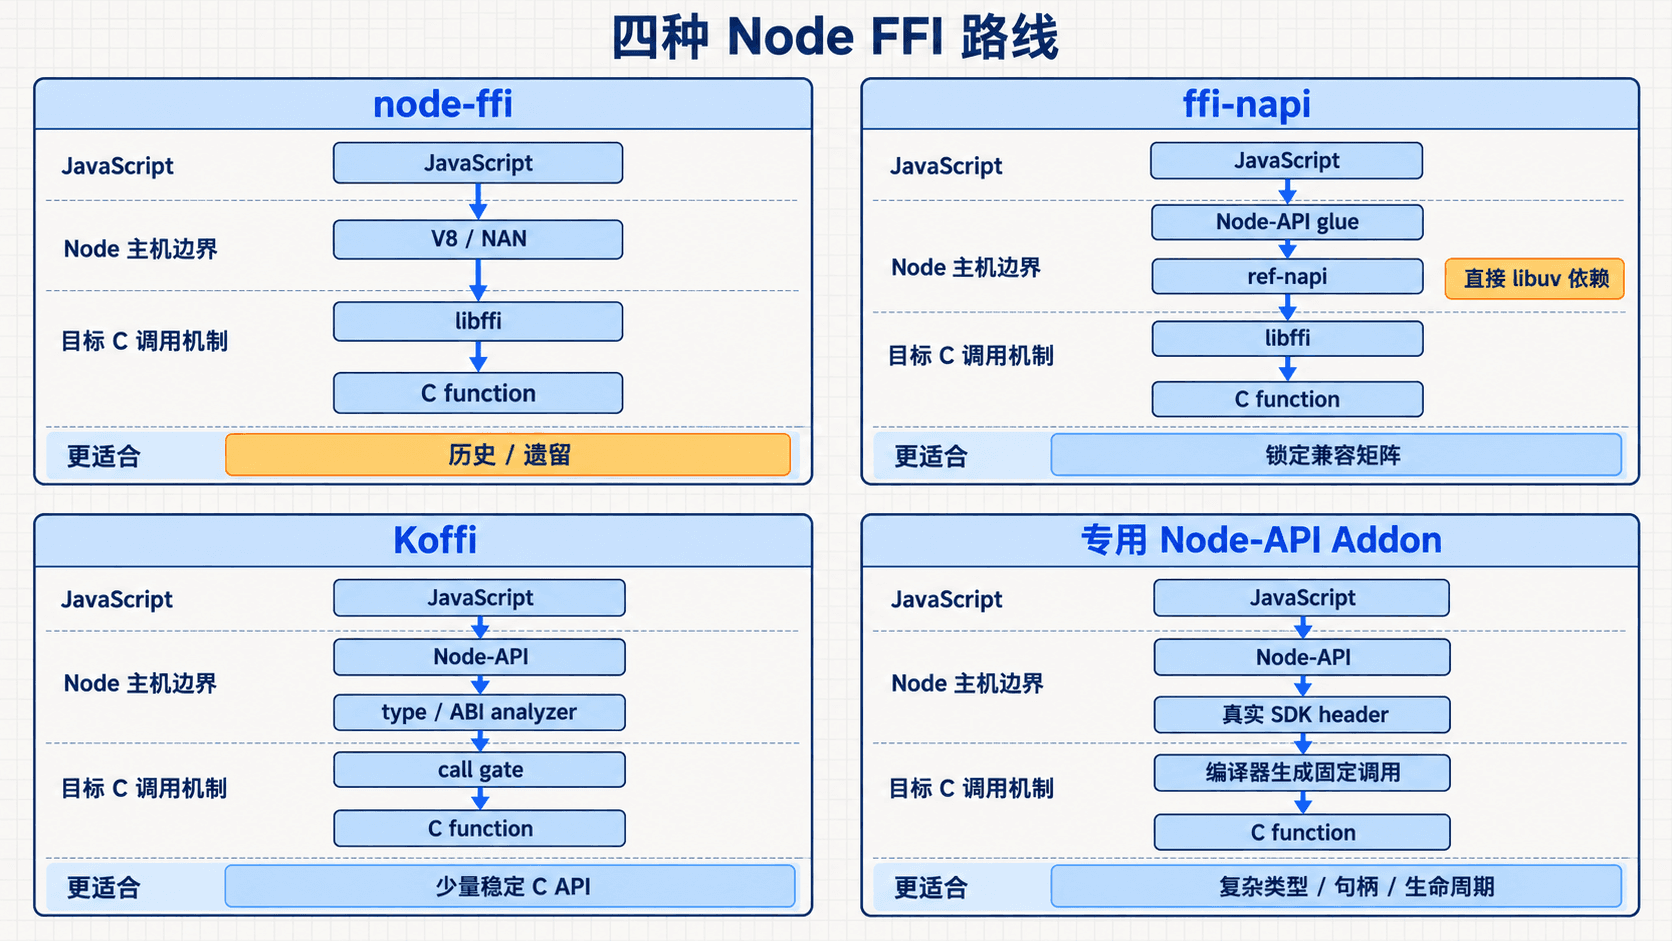
选择时先看接口,不看框架名:只有少量稳定的 scalar function,运行时 FFI 通常足够;一旦出现复杂 struct、长期 handle、foreign-thread callback 或严格 shutdown,专用 Addon 更容易把约束收在一个地方;如果 native binary 不可信或可能永久卡住,再增加独立进程边界。
7. 调用结果不对时,沿这条路径排查
| 检查点 | 对这次 divide 要确认什么 |
|---|---|
| 动态库 | 路径、CPU architecture 和依赖库是否正确 |
| Symbol | divide 的名字、name mangling 和 version 是否匹配 |
| Prototype | 两个 double 参数、double 返回值和 calling convention 是否与 header 相同 |
| Storage | a、b、result 与 CIF 是否都是 double |
原型核对永远对着真实 header,不根据一次输出反推声明。接口扩展到 struct 或 pointer 后,再追加 sizeof / offsetof、pointer lifetime 和 allocator 配对的检查。安全实验只使用自己编译的极小 fixture 和明确签名,不加载来源不明的 native binary。
下一篇沿用这条调用链,追踪另一种控制流:C 不再只是返回一个值,而是在稍后从自己的线程调用 Node 注册的 function pointer。
References
- Node.js: Node-API ABI stability
- node-addon-api
- libffi: The Basics
- System V Application Binary Interface: AMD64 Architecture Processor Supplement
- Microsoft Learn: x64 calling convention
- Koffi: Load libraries and declare functions
- Koffi 3.2.1 source: ABI analyzer and call gate
- ffi-napi 4.0.3 source: Node-API and direct libuv coupling
Discussion
留言与讨论
想法、补充和不同意见都欢迎。